MACULA
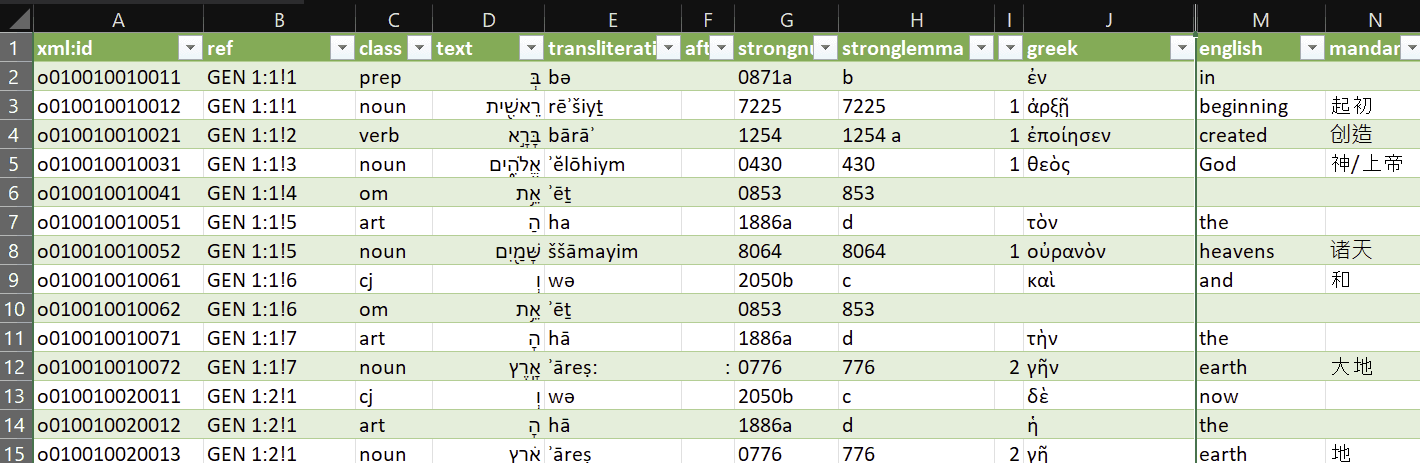
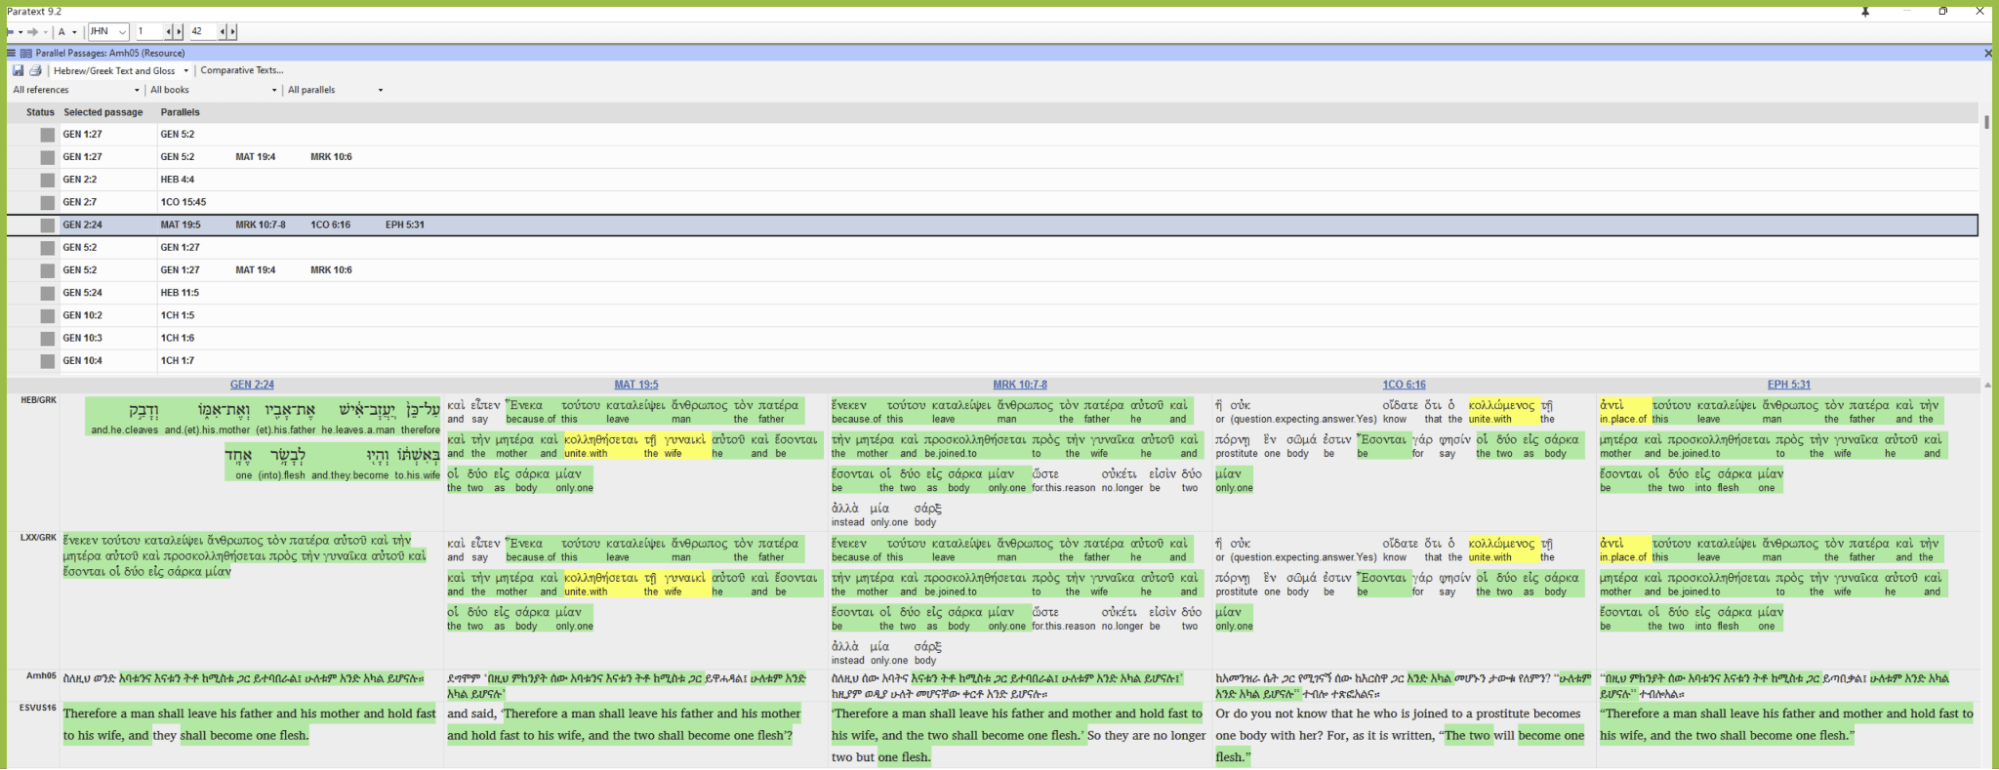
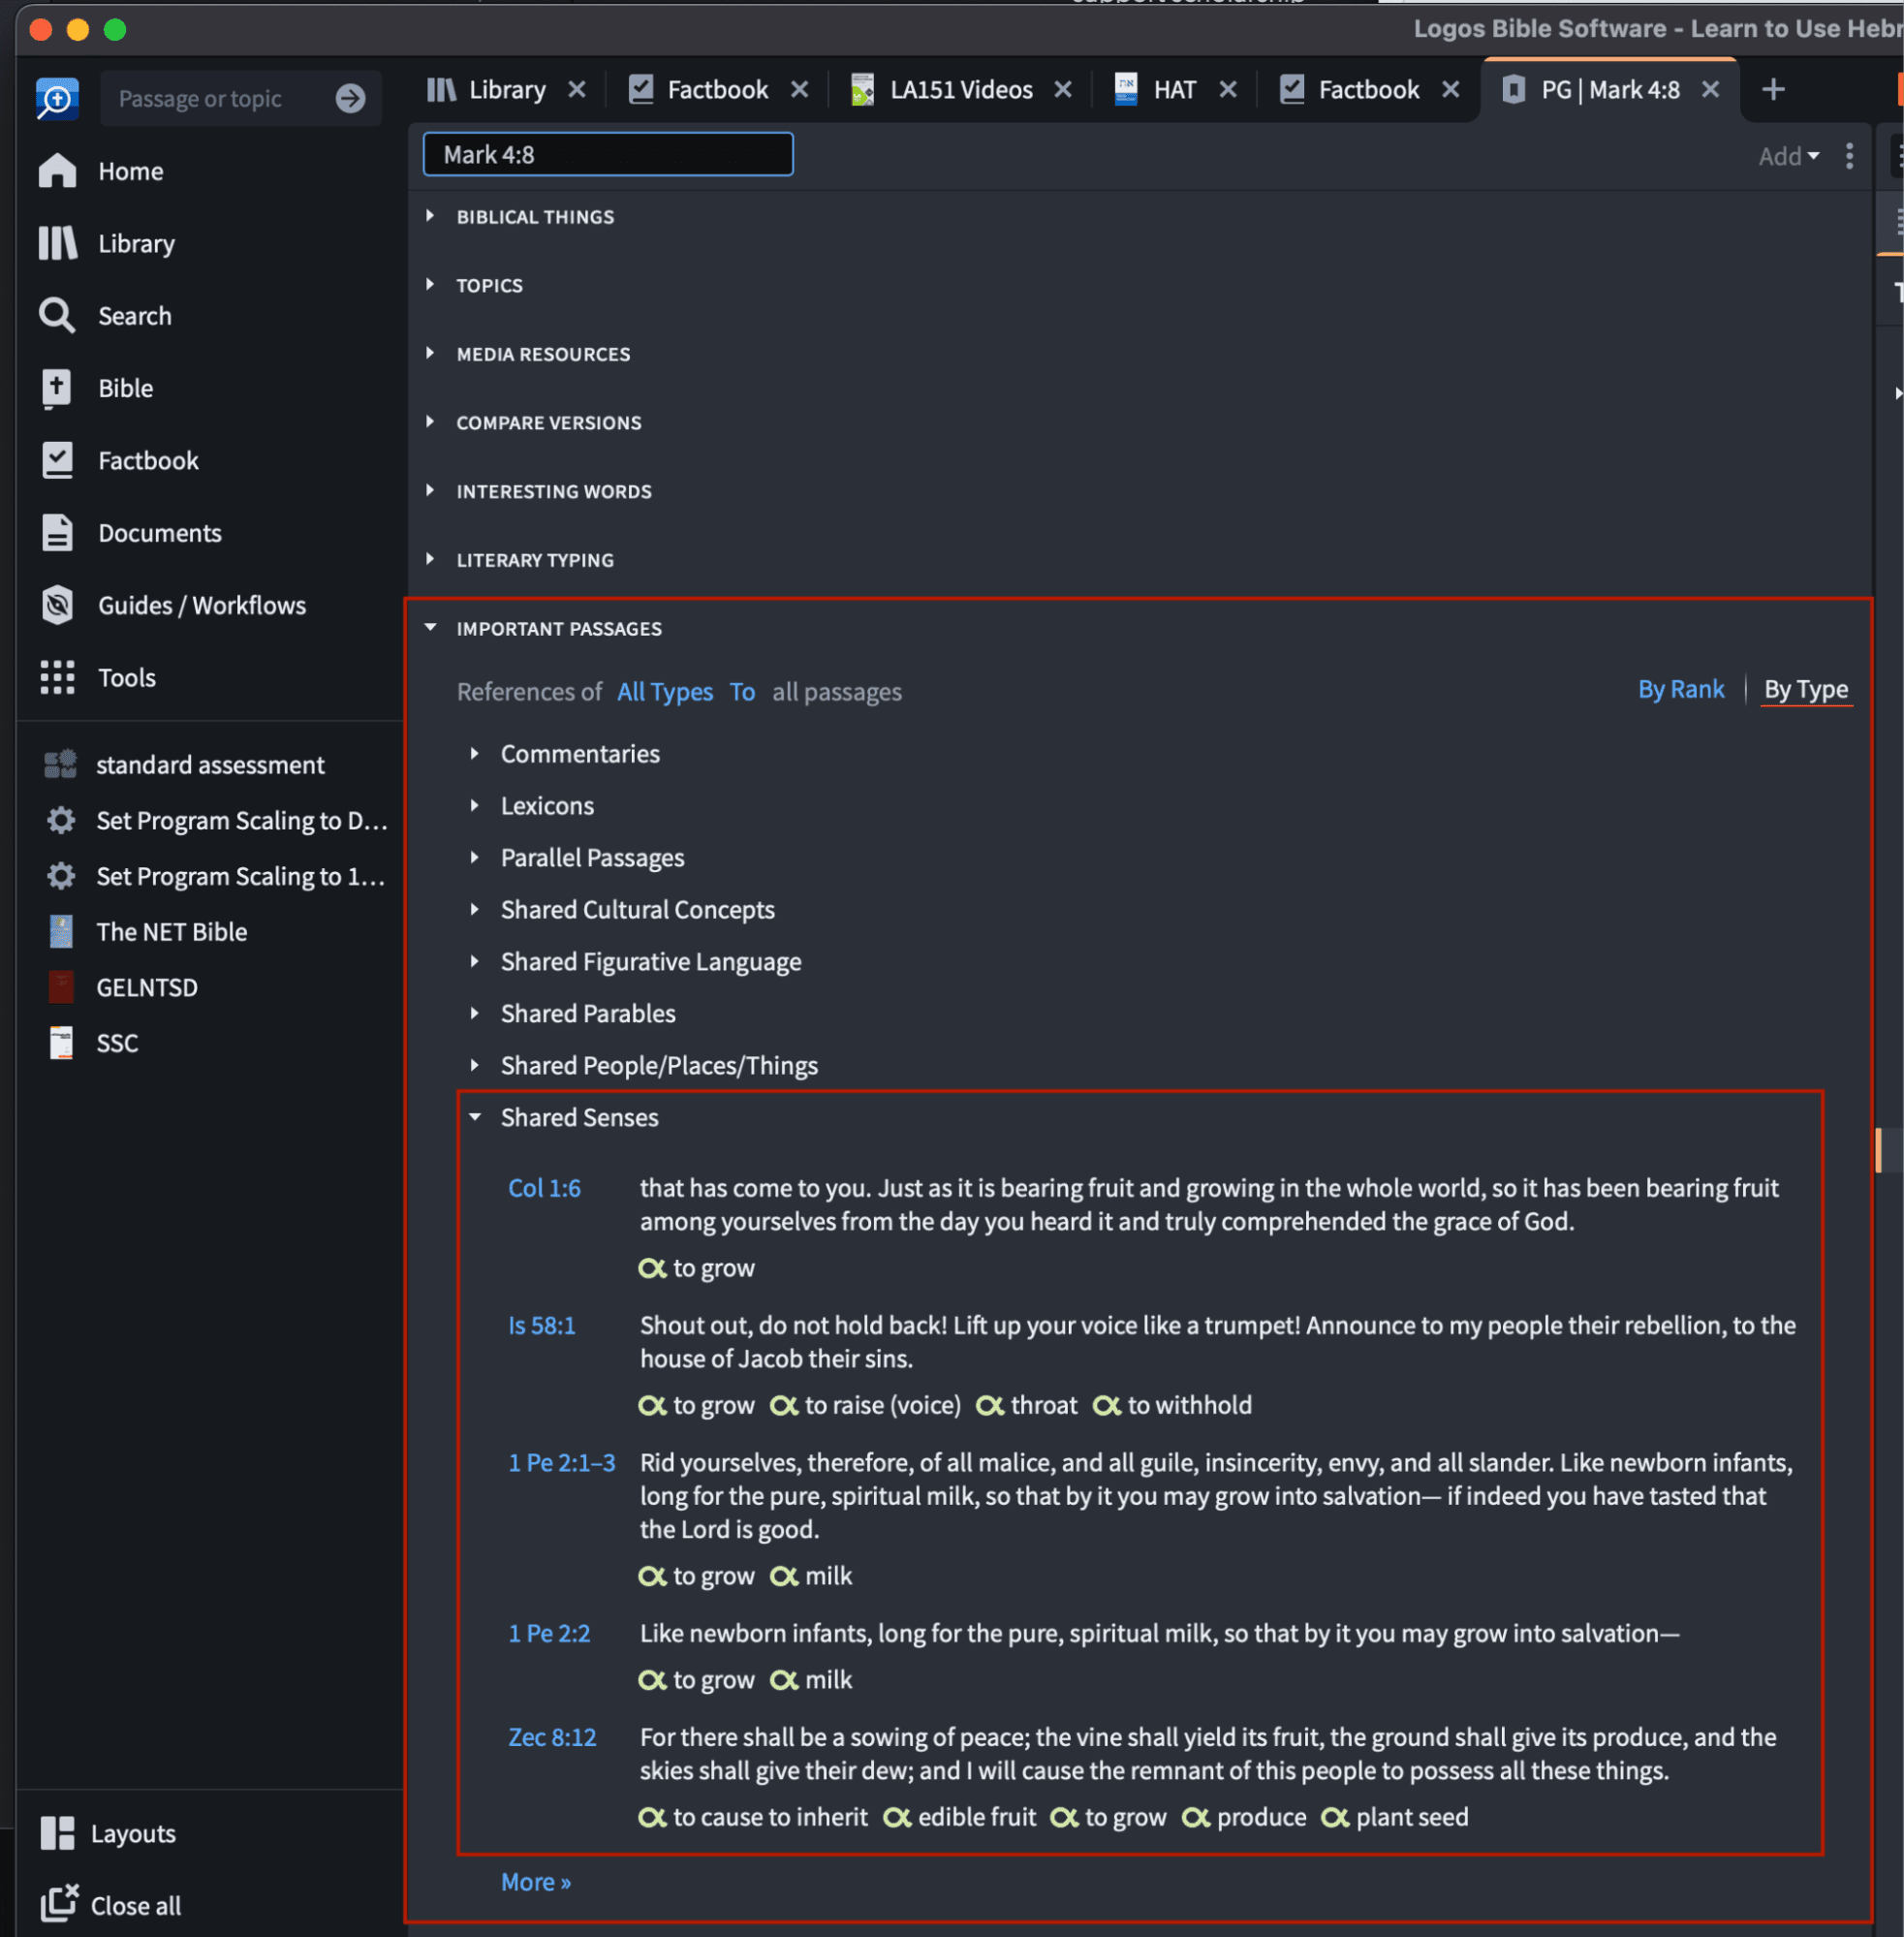
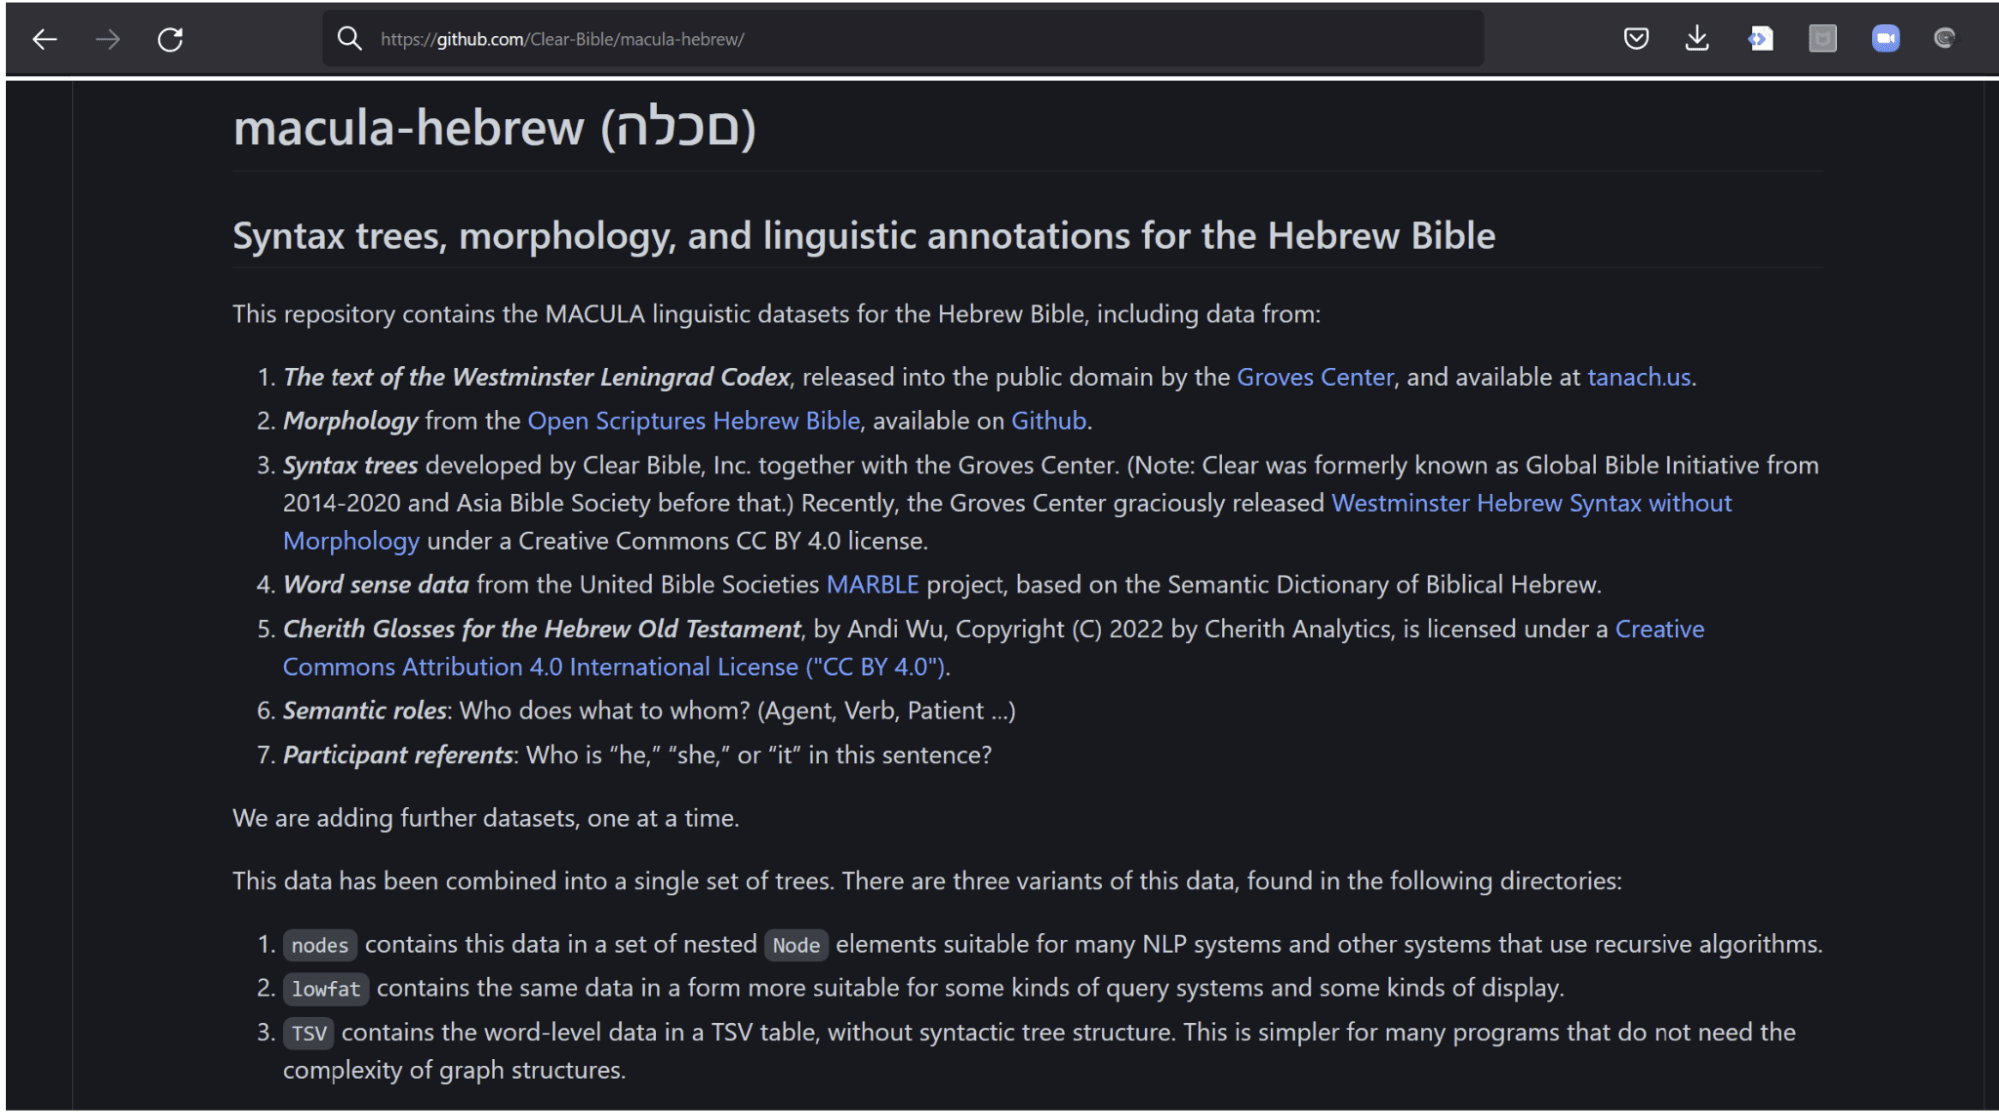
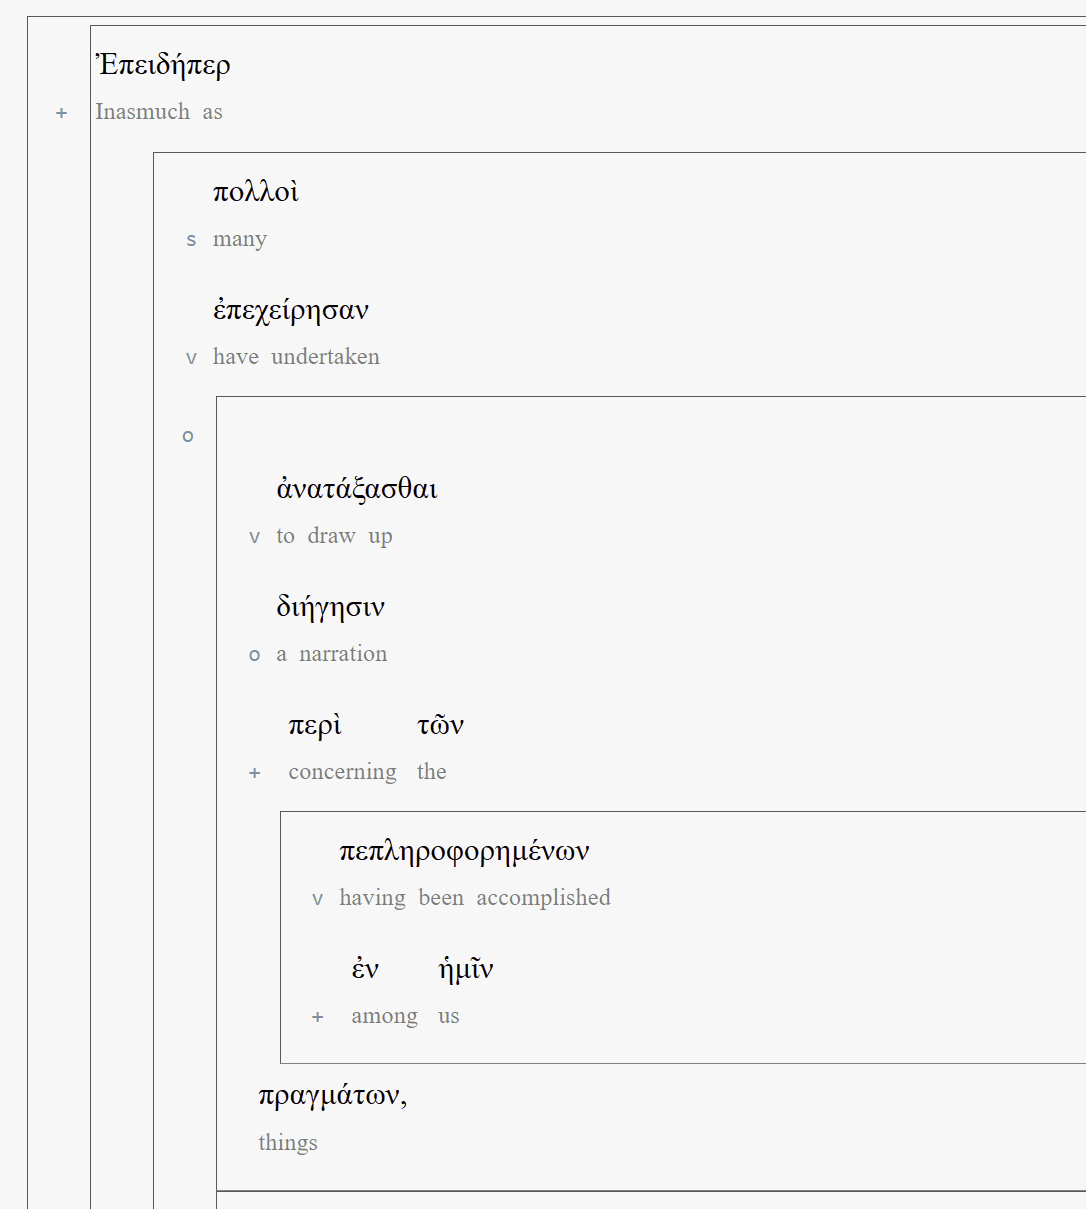
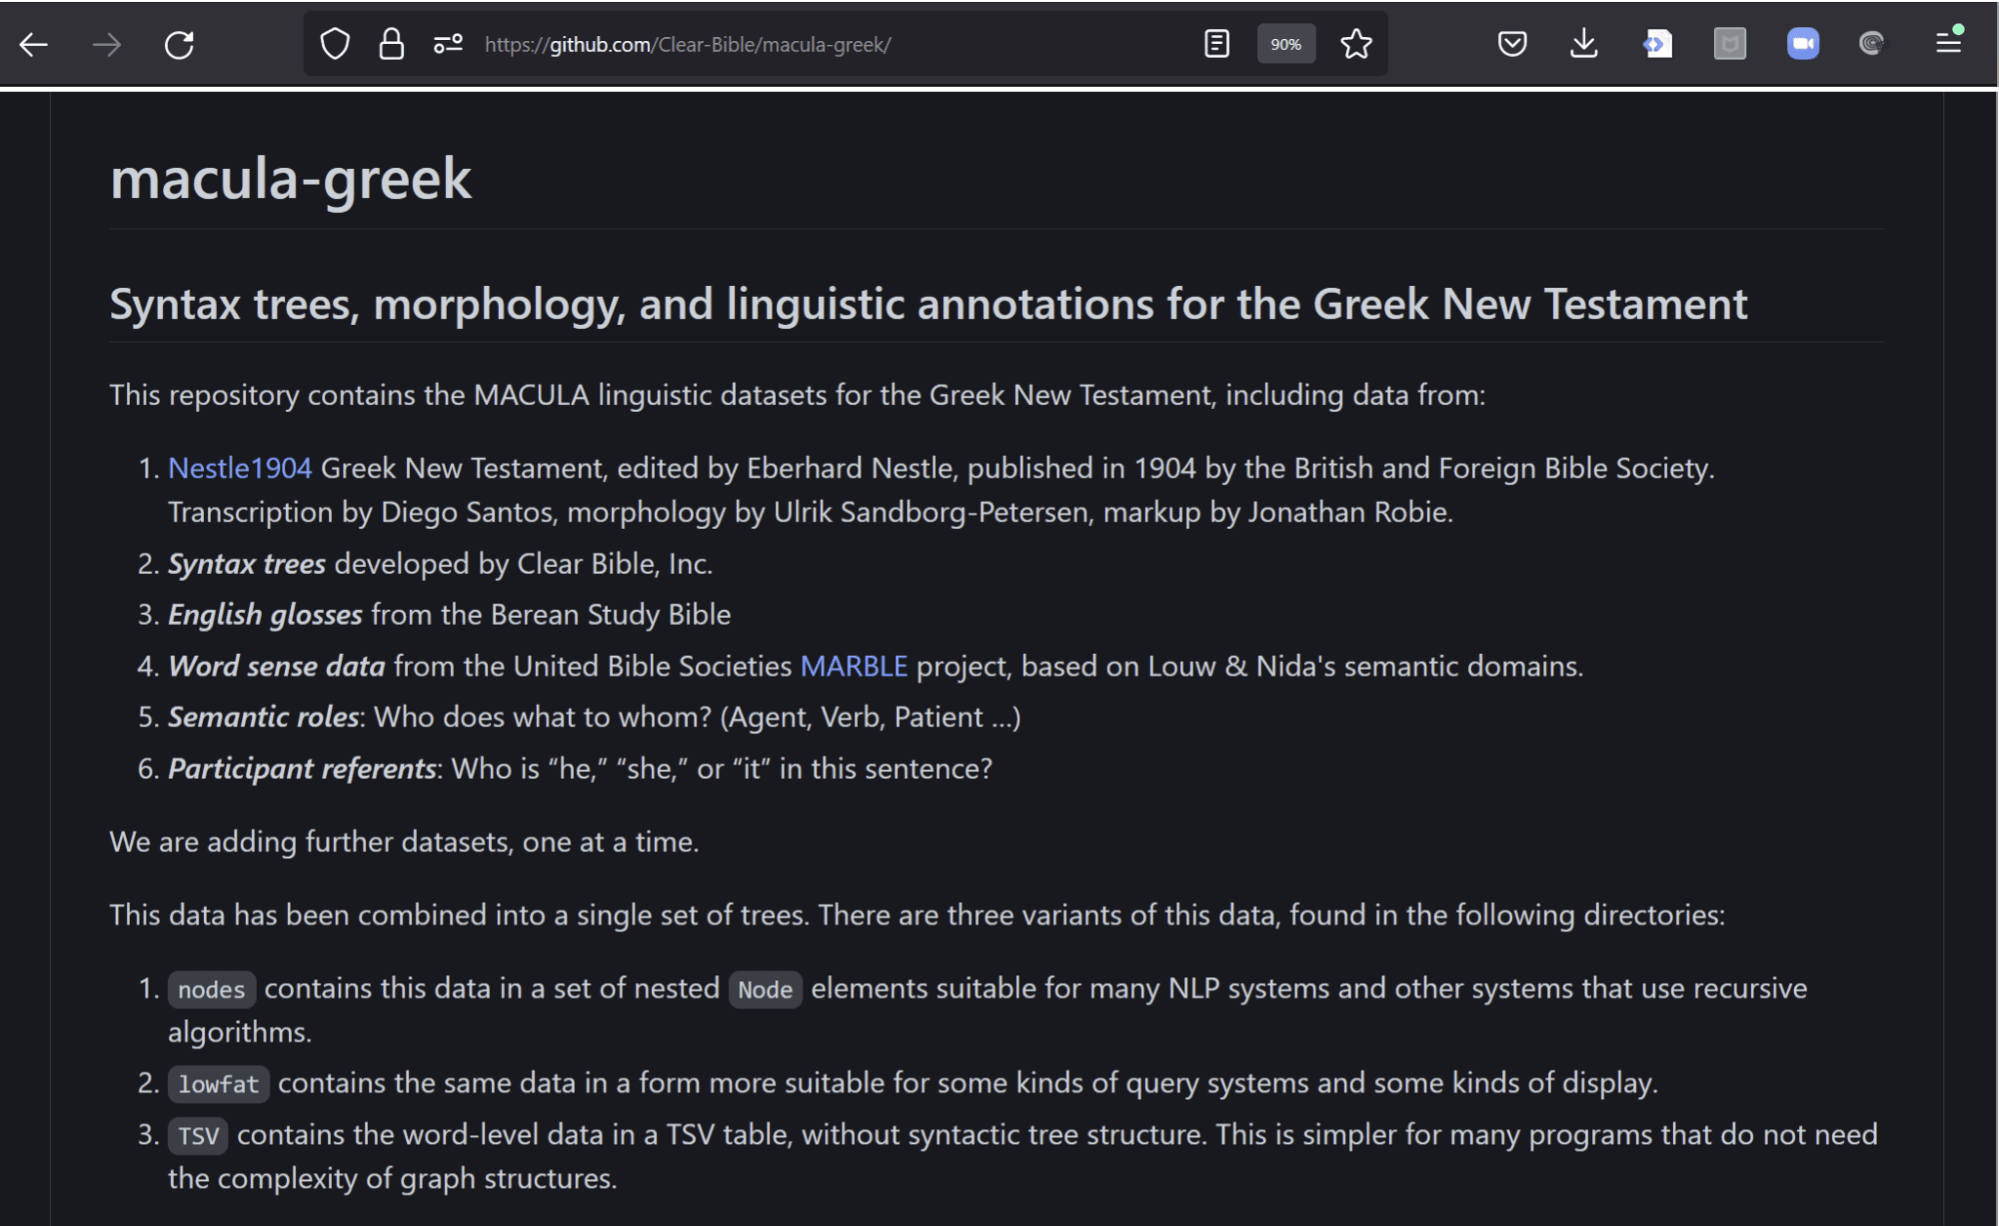
MACULA incluye conjuntos de datos ricos (accesibles vía GitHub y vía una API). Estos conjuntos de datos proporcionan muchas capas de descripción lingüística para cada oración de la Biblia Hebrea y el Nuevo Testamento Griego, incluyendo estructura sintáctica, morfología, dominios semánticos, relaciones, referentes, glosas, y citas, y otros aspectos.
MACULA puede ser utilizado por creadores de recursos o investigadores con amplio conocimiento de idiomas bíblicos y lingüística, o por programadores y profesionales de NLP que no conocen hebreo y griego. Los conjuntos de datos de MACULA tienen licencia libre y están disponibles en GitHub.
https://github.com/Clear-Bible/macula-hebrew
https://github.com/Clear-Bible/macula-greek
Usando estos conjuntos de datos como base, Clear está en el proceso de crear entornos de usuario tanto para eruditos de idiomas bíblicos como para estudiantes serios de la Biblia que no conocen griego o hebreo.
Pantallas
Testimonios
"Como Científico de Datos que quiere procesar los textos bíblicos, he encontrado que el dataset MACULA es extremadamente útil. Los datos son de muy alta calidad, ¡y es muy sencillo para mí importarlos y usarlos en el desarrollo de aplicaciones!"
Mark Woodward, Científico de Datos, SIL International
"Los conjuntos de datos de MACULA ayudan a los consultores de traducción a reconocer rápidamente las características, incluyendo la referencia de participantes y el sentido de las palabras, de los textos bíblicos. Apreciamos la manera en que ya integra UBS y otros conjuntos de datos y esperamos datos aún más ricos en el futuro."
Milt Jones, VP de Traducción Bíblica en Seed Company
"Los datos de MACULA han sido un cambio radical para nuestro equipo mientras tratamos de evaluar las cualidades de los borradores de traducción bíblica. La información de dominios semánticos y las glosas nos ayudan a encontrar información faltante, añadida o modificada durante la revisión."
Daniel Whitenack, Científico de Datos, SIL International