MACULA
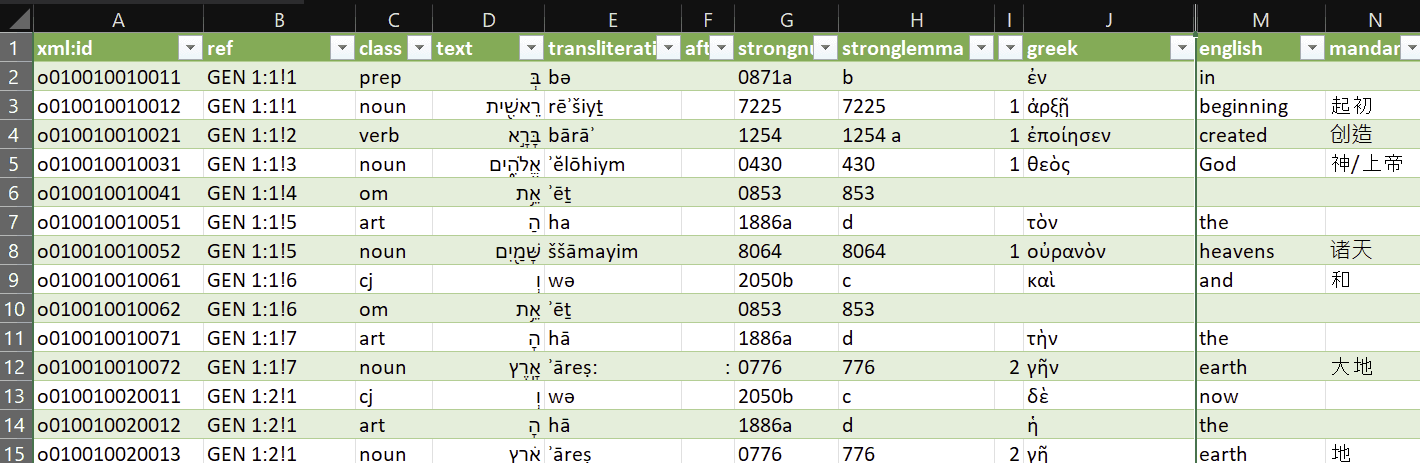
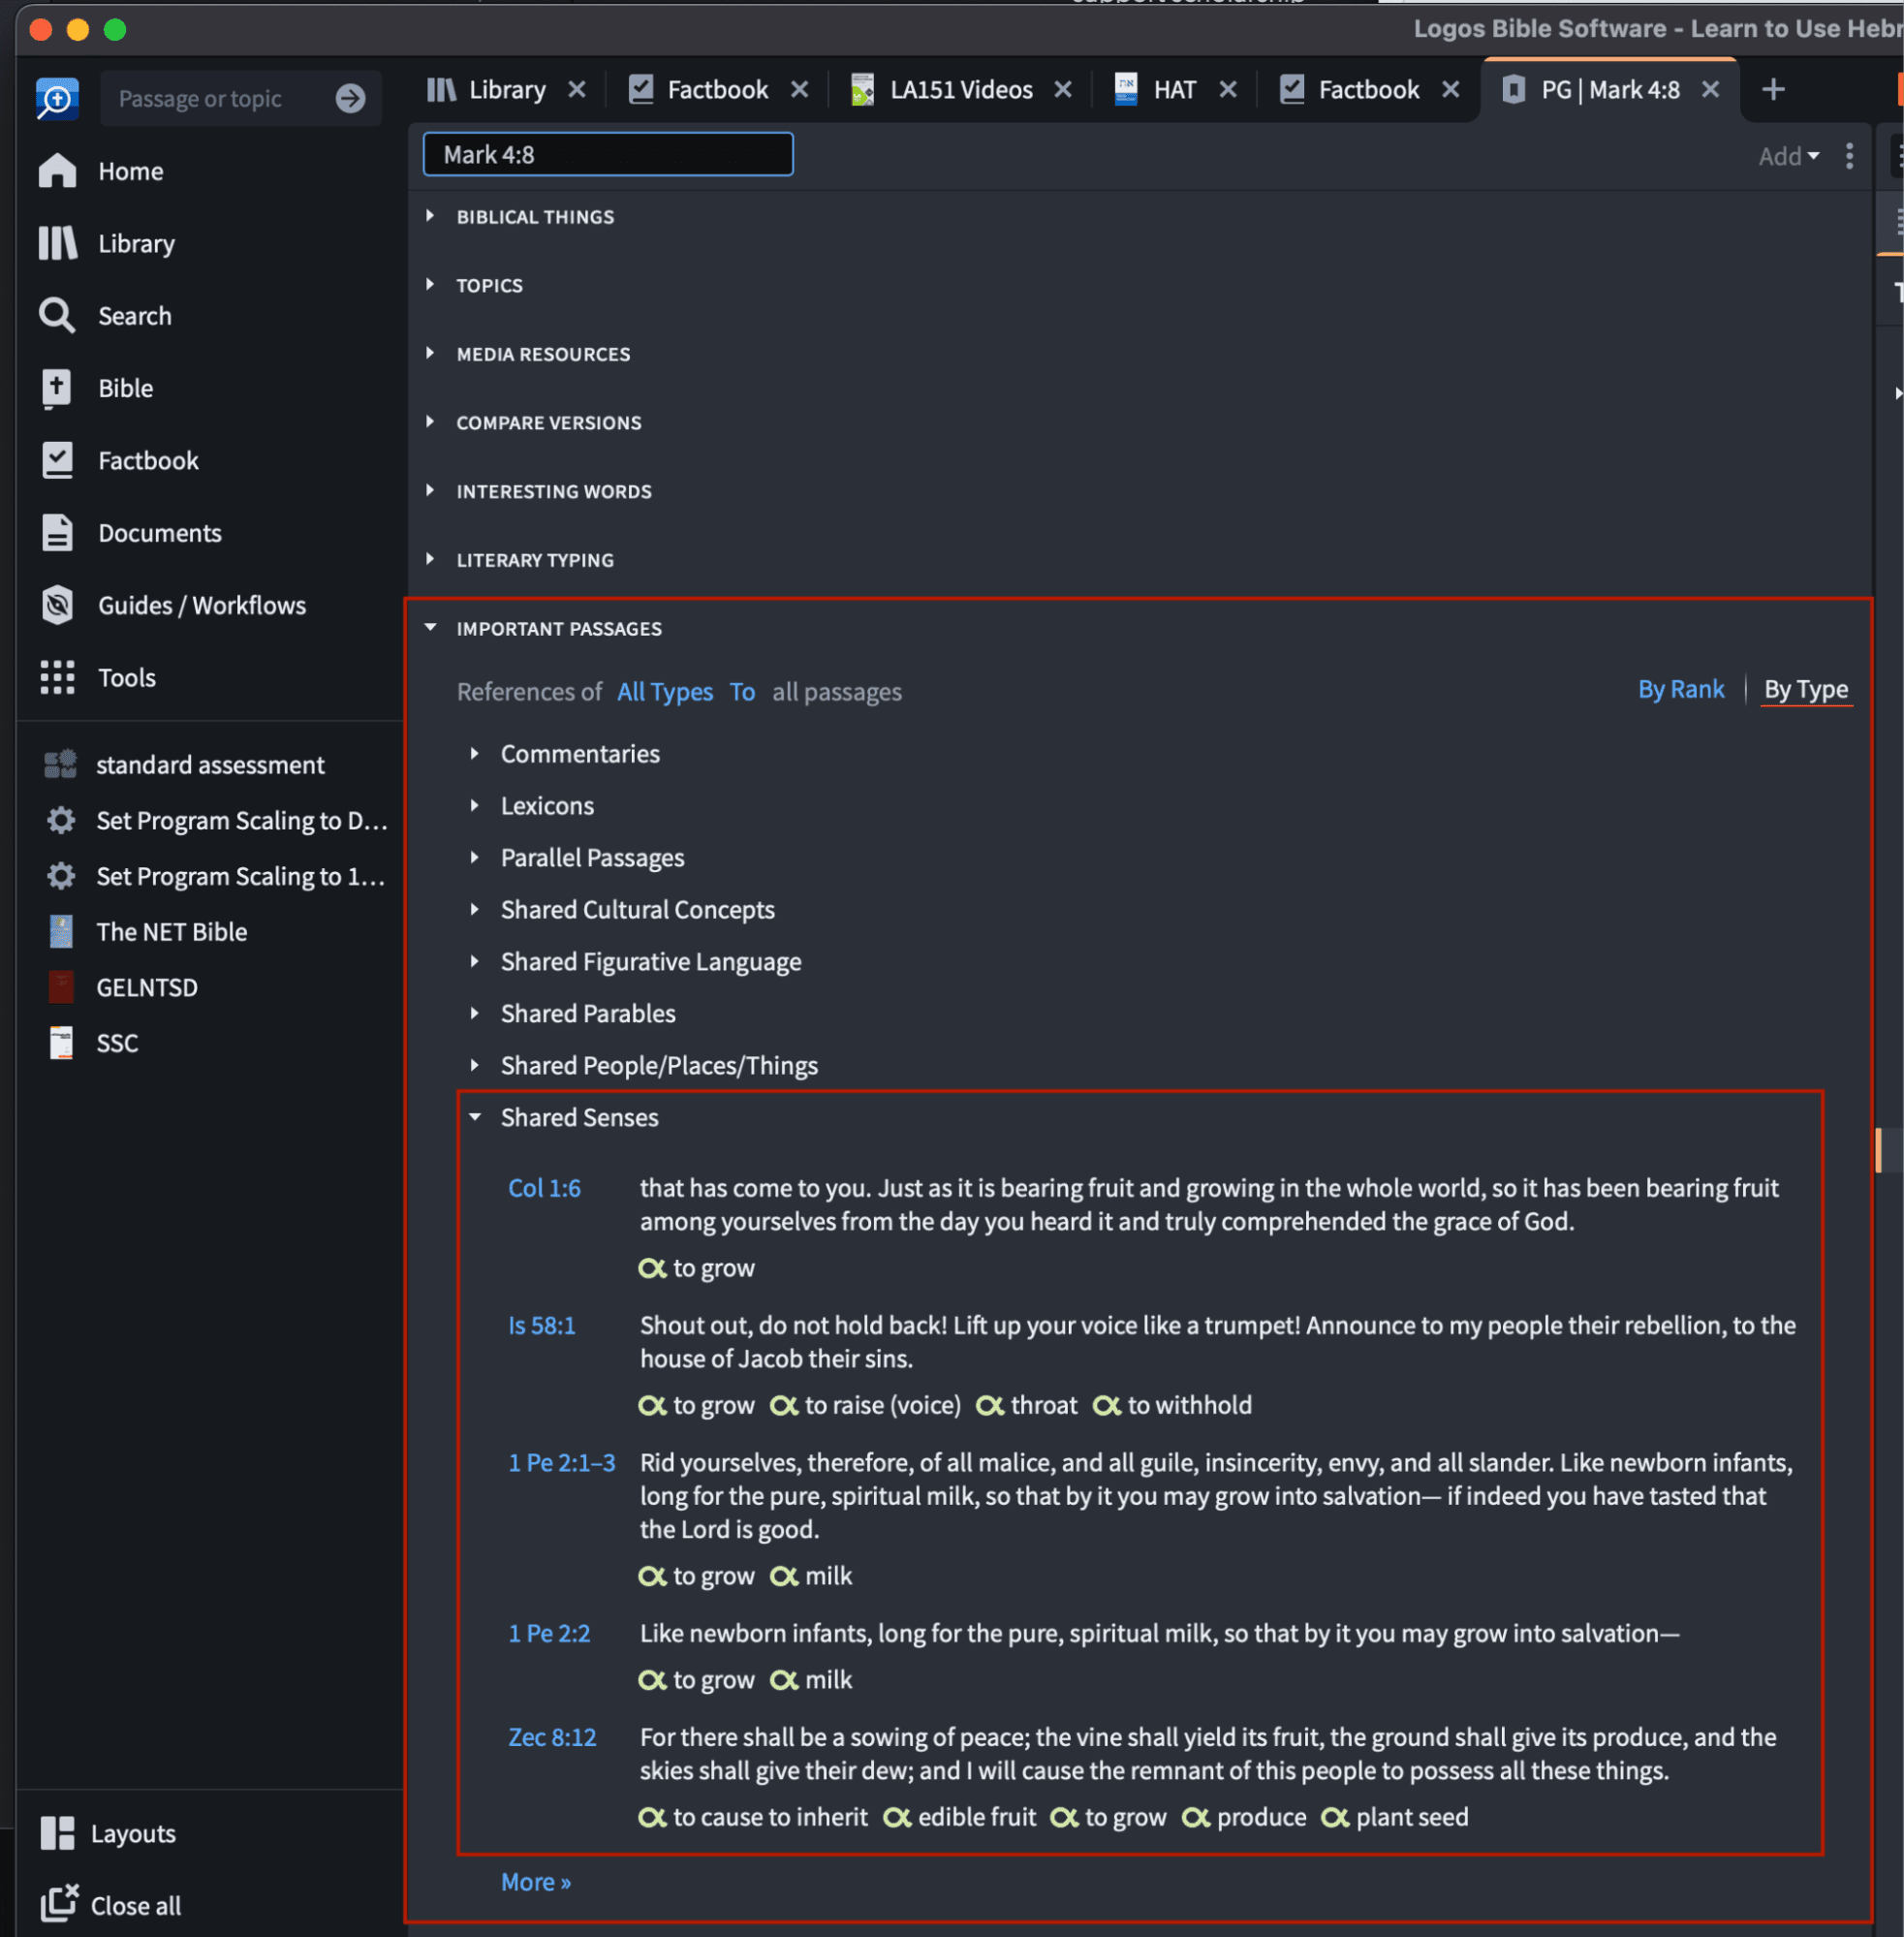
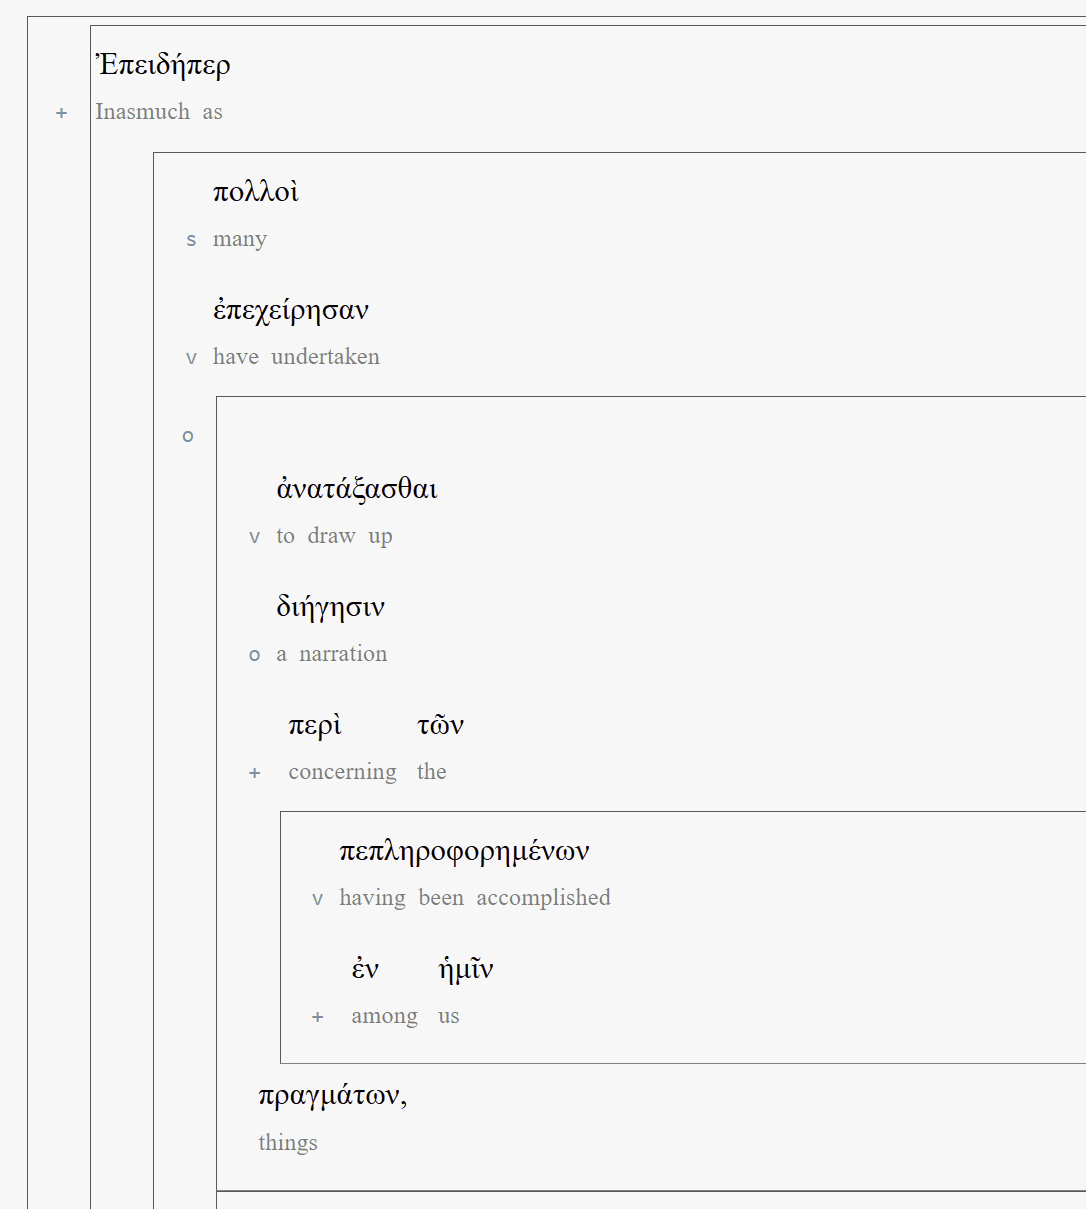
MACULA termasuk dataset yang kaya (boleh diakses melalui GitHub dan melalui API). Dataset ini menyediakan banyak lapisan penerangan linguistik untuk setiap ayat Bible Ibrani dan Perjanjian Baru Yunani, termasuk struktur sintaksis, morfologi, domain semantik, hubungan, rujukan, glos, dan petikan, dan aspek lain.
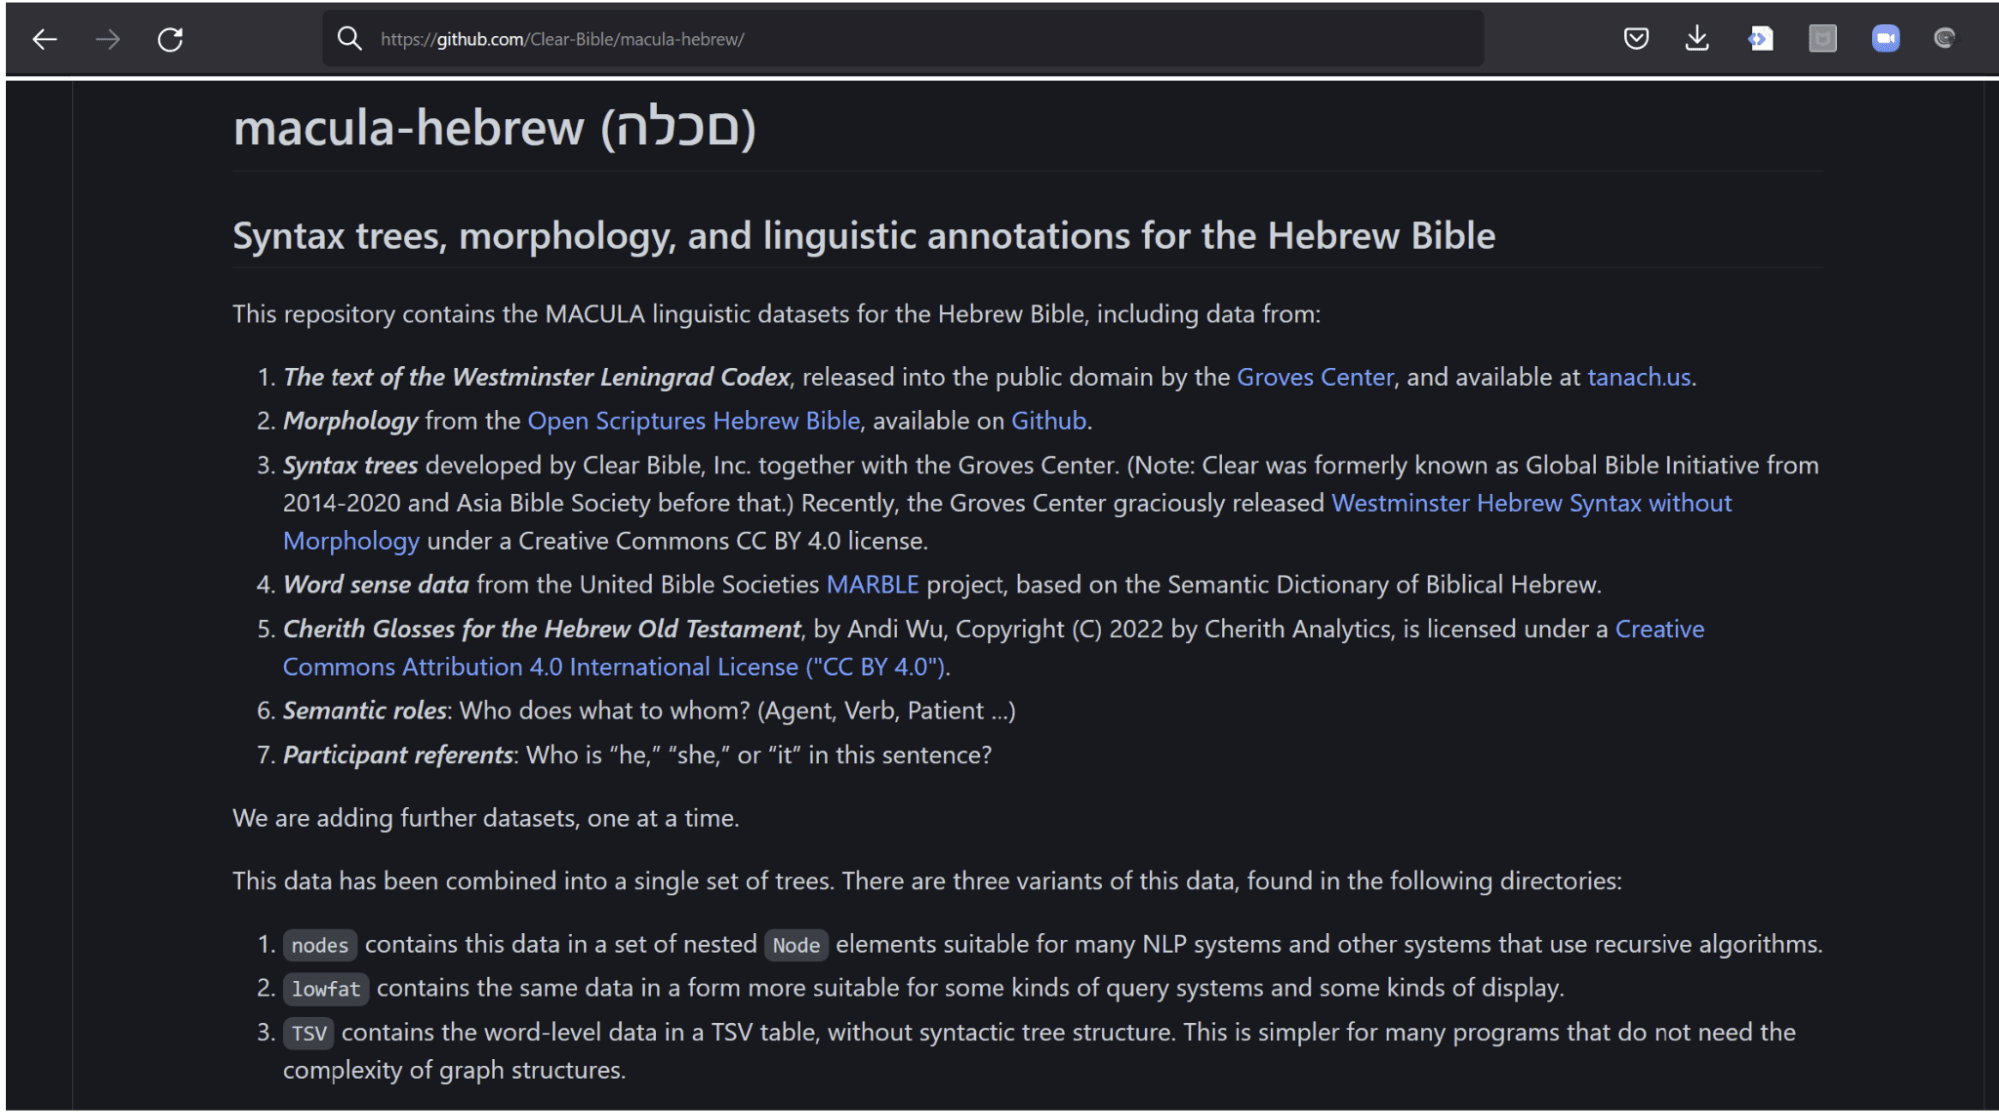
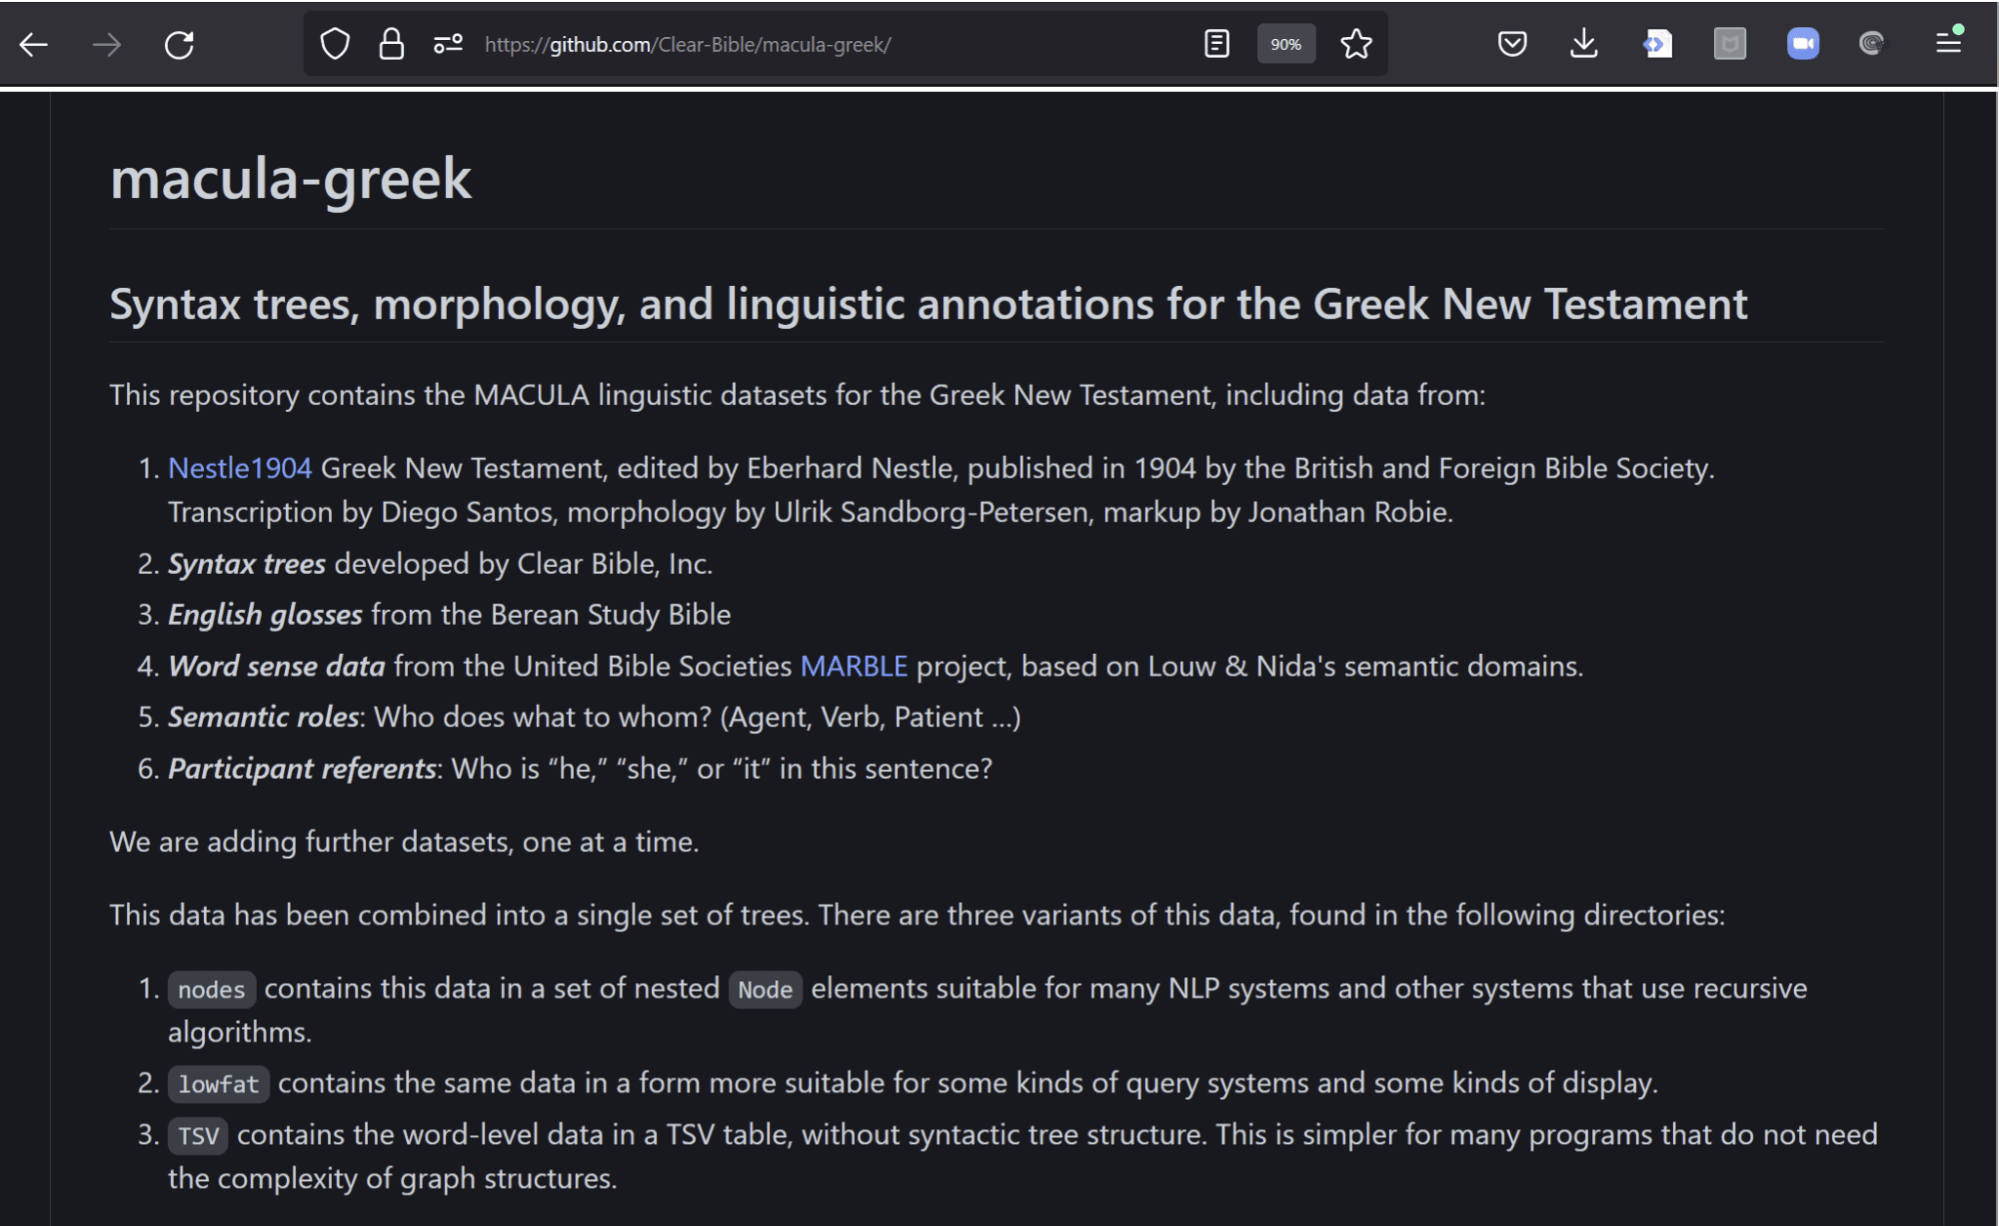
MACULA boleh digunakan oleh pencipta sumber atau penyelidik dengan pengetahuan yang luas tentang bahasa dan linguistik alkitabiah, atau oleh pengaturcara dan pengamal NLP yang tidak tahu bahasa Ibrani dan Yunani. Dataset MACULA berlesen percuma dan tersedia di GitHub.
https://github.com/Clear-Bible/macula-hebrew
https://github.com/Clear-Bible/macula-greek
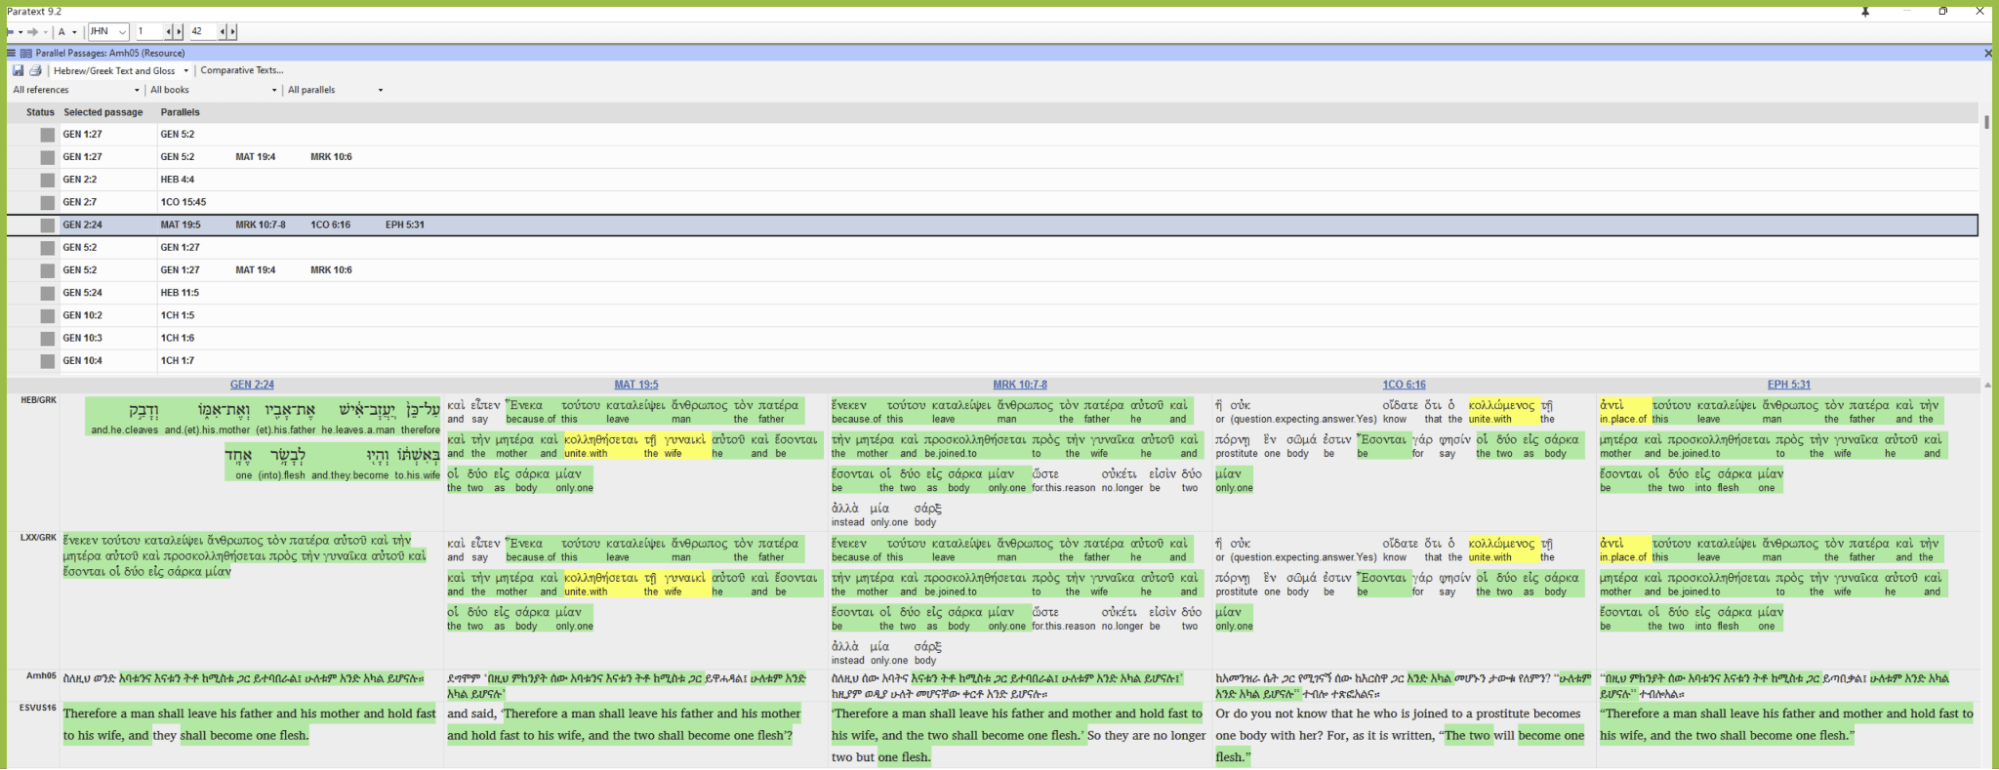
Menggunakan dataset ini sebagai asas, Clear sedang dalam proses mencipta persekitaran pengguna untuk kedua-dua sarjana bahasa alkitabiah dan pelajar Bible yang serius yang tidak tahu bahasa Yunani atau Ibrani.
Skrin
Testimoni
"As a Data Scientist wanting to process the biblical texts, I have found the MACULA dataset to be extremely useful. The data is very high quality, and it's very straightforward for me to import and use it in developing applications!"
Mark Woodward, Data Scientist, SIL International
"The MACULA data sets help translation consultants quickly recognize features, including participant reference and word sense, of the biblical texts. We appreciate the way it already integrates UBS and other data sets and look forward to even richer data in the future."
Milt Jones, VP Bible Translation at Seed Company
"MACULA data has been a game changer for our team as we try to estimate the qualities of Bible translation drafts. The semantic domain information and glosses help us find missing, added, or modified information during review."
Daniel Whitenack, Data Scientist, SIL Internationa